Задачи распознавания изображений обладают интересным свойством. Вот смотришь на картинку и видишь прямую, которая образована разбросанными точками. Как только пытаешься получить эту прямую по данным точек в программе — сразу возникают алгоритмические трудности.
Что поделаешь, это еще одно напоминание о том, что человеческий глаз — это совершенное средство обработки данных.
В этом примере прямая — это некоторая закономерность, которую нужно найти в потоке данных. Где может пригодиться такой алгоритм? Например, в распознавании маркеров взлетно — посадочной полосы оптической системы посадки БПЛА. Или хотя бы определить направление, в котором дедушка Ляо идет из кабачка домой.
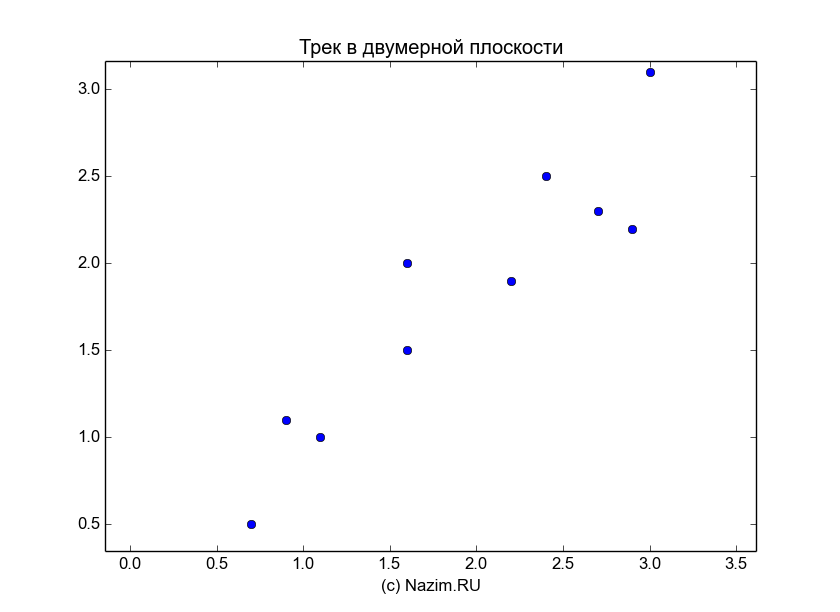
Понаблюдаем же за дедушкой Ляо. Хорошо посидев с друзьями своей юности в кабачке, он спешит к домашнему очагу. Как видно из карты перемещений, у дедушки Ляо не очень уверенная походка. Тем не менее, очевидно что он стойко идет к своей цели. Очевидно для нас, потому что мы пользуемся совершенными инструментами — собственными глазами. А что делать компьютеру? Как ему выявить закономерность на основе данных десяти точек?
Для этого можно использовать понятие собственных чисел и собственных векторов матрицы. Поскольку теорию мало кто любит и тем более мало кто запоминает, рассмотрим эти понятия на простом примере и затем вернемся к дедушке Ляо во всеоружии.
Матрицы линейного преобразования: портим фигуру
По старой доброй традиции, воспользуемся богатыми математическими возможностями Питона. Не мудрствуя лукаво, нарисуем следующую фигурку — двойной ромбик:
tst = np.mat([ [-3,-2,-2,-1,-1,0,0,1,1,2,2,3],
 [0,-1,2,-2,4,-3,6,-2,4,-1,2,0] ])
Для наглядности можно вывести значение этой матрицы на экран:
[[-3 -2 -2 -1 -1 0 0 1 1 2 2 3]
 [ 0 -1 2 -2 4 -3 6 -2 4 -1 2 0]]
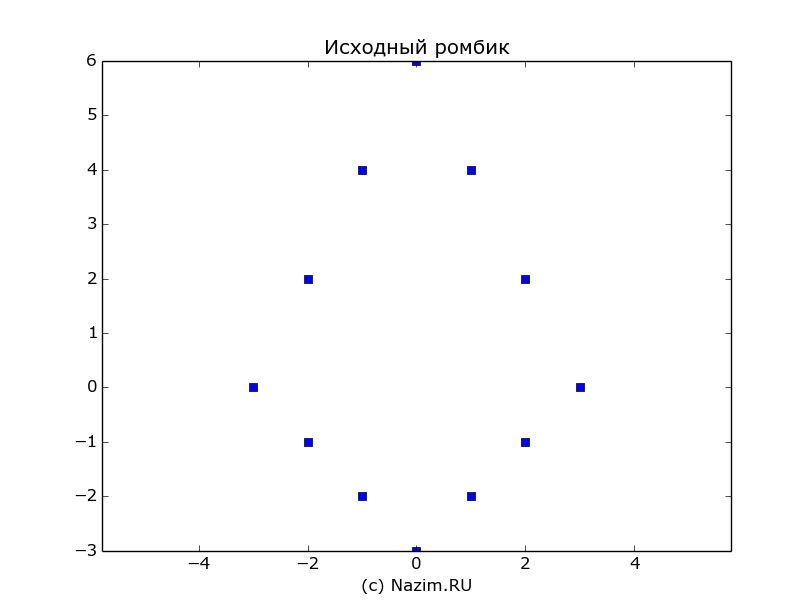
Матрица определяет фигурку из 12 точек, первая строка — x координаты точек, вторая строка — y координаты. Выглядит фигурка так:
На этом с исходными данными все. Теперь начинается самое интересное: мы будем портить нашу фигурку. Для этого матрицу фигурки умножаем на матрицу линейного преобразования A, которая может растягивать фигурку по горизонтали:
A = np.mat([[2,0],[0,1]])
Или сжимать также по горизонтали:
A = np.mat([[0.5,0],[0,1]])
Растягивать по вертикали:
A = np.mat([[1,0],[0,2]])
Перекос:
A = np.mat([[1,1],[0,1]])
Мы можем даже повернуть фигурку, например на 30° по часовой стрелке. Как вы догадываетесь по значению элементов матрицы линейного преобразования, не обошлось без синусов и косинусов соответствующего угла поворота:
A =
[[ 0.87 0.5 ]
 [-0.5 0.87]]
Или вообще вместе со сжатием и растяжением еще перекосить ее так, что сразу и не узнаешь:
A = np.mat([[1.2,0.5],[0.2,1.2]])
Воспользуемся последним преобразованием и скособочим нашу фигурку:
TST = A*tst
[[-3.6 -2.9 -1.4 -2.2 0.8 -1.5 3. 0.2 3.2 1.9 3.4 3.6]
 [-0.6 -1.6 2. -2.6 4.6 -3.6 7.2 -2.2 5. -0.8 2.8 0.6]]
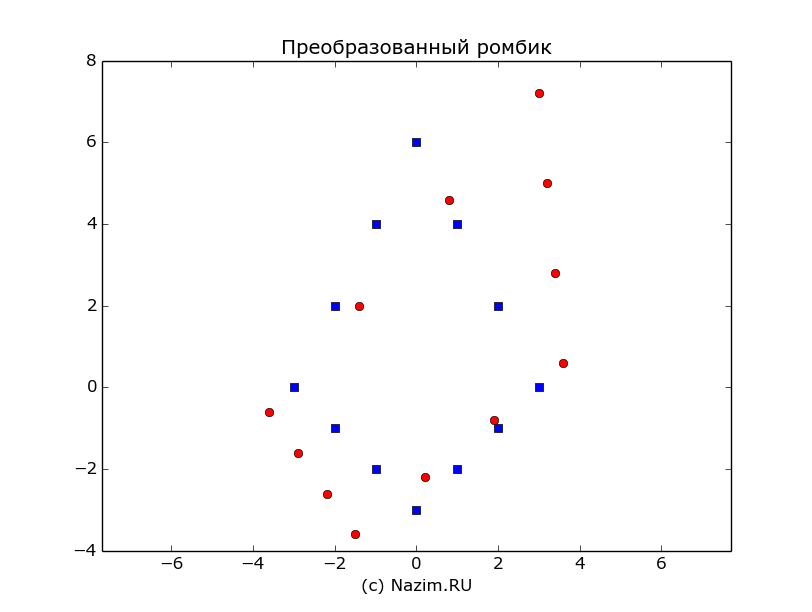
Матрица линейного преобразования A перевела 12 наших исходных векторов на другие позиции, то есть поменяла их координаты: на то оно и преобразование.
Однако, существуют такие векторы, которые напрочь отказываются преобразовываться. При попытке матрицы линейного преобразования сжать их, растянуть, перекосить или повернуть они переходят сами в себя. Для каждого линейного преобразования эти векторы свои, поэтому они называются собственными векторами матрицы. Есть еще и собственные числа, которые участвуют во всем этом следующим образом: эффект от линейного преобразования собственного вектора такой же, как будто бы его просто умножили на собственное число. Проще говоря, собственное число — просто масштабирующий множитель. Матрице конечно обидно, что она ничего не может сделать с собственным вектором и ее многомерный эффект преобразования сводится к простому умножению на число. Но что поделать!
Вскрытие собственников
Найдем собственные числа и собственные векторы нашей матрицы преобразования A. На Питоне это делается одной строчкой:
w, v = np.linalg.eig(A)
Я придерживаюсь обозначений, которые показаны в примерах модуля numpy Питона: w — это собственное число, v — собственный вектор. Неудобно, что слова vector и value начинаются на одну и ту же букву, и поскольку вектор главнее, собственное число получило наименование w.
Посмотрим что получилось:
A =
[[ 1.2 0.5]
 [ 0.2 1.2]]
v =
[[ 0.85 -0.85]
 [ 0.53 0.53]]
w =
[ 1.52 0.88]
Очевидно, что для нашей матрицы линейного преобразования существуют два собственных вектора и два собственных числа.
Первая парочка:
v1 =
[[ 0.85]
 [ 0.53]]
w1 =
1.52
Наступил момент истины. Подвергнем вектор линейному преобразованию:
A*v1 =
[[ 1.28]
 [ 0.81]]
w1*v1 =
[[ 1.28]
 [ 0.81]]
Так оно и есть: собственный вектор «не чувствует» родную матрицу A и остается таким же, как и был, точнее — умноженным на собственное число.
Проверка второй парочки:
v2 =
[[-0.85]
 [ 0.53]]
w2 =
0.88

A*v2 =
[[-0.75]
 [ 0.47]]
w2*v2 =
[[-0.75]
 [ 0.47]]
Тоже самое: какого-либо желания трансформироваться не обнаружено напрочь.
Principal Component Analysis (PCA), или Метод главных компонент в поисках закономерностей
Теперь мы хорошо подготовлены к тому, чтобы переварить идею метода PCA, вынесенного в заголовок. Метод основан на поиске осей максимальных изменений входных данных; эти оси называются компонентами, что и послужило основой для названия метода. Подробное и самое главное — понятное описание метода для химических приложений изложено здесь (вспоминая замечательный журнал Химия и жизнь).
На самом деле, кроме поиска закономерностей, метод выполняет еще одну задачу: отделяет существенные данные от несущественных; и кроме этого обладает еще одним важным свойством, о котором я скажу в конце. Применив этот метод, мы наконец узнаем, каков на самом деле был кратчайший маршрут дедушки Ляо и что считать его действительным направлением движения, а что — отклонениями (эх, дедушка Ляо, если бы ты меньше просиживал в кабачке то не пришлось бы связываться с отклонениями!).
Мы неспроста тренировались на собственных векторах и числах, поскольку они являются основой для реализации метода PCA (есть и другие реализации). Если мы поняли это, то до понимания реализации метода остался только один шаг. Этот шаг — использование матрицы линейного преобразования как ковариационной матрицы выходных данных.
Итак, начнем с выборки следов дедушки Ляо, которую для солидности будем именовать треком из 10 точек:
track =
[[ 2.4 0.7 2.9 2.2 3. 2.7 1.6 1.1 1.6 0.9]
 [ 2.5 0.5 2.2 1.9 3.1 2.3 2. 1. 1.5 1.1]]
Уберем из трека постоянную составляющую и найдем ковариационную матрицу трека:
np.cov(track) =
[[ 0.717 0.615]
 [ 0.615 0.617]]
Сделаем передышку и осмыслим сделанное (физический смысл — основа любого метода). О чем говорит ковариацонная матрица? Одинаковые значения 0.615 говорят о степени связи (корреляции) переменных x[0..9] и y[0..9], которые являются соответствующими координатами трека (простите, в Питоне индексы начинаются с нуля). Элементы главной диагонали 0.717 и 0.617 говорят о корреляции этих переменных с собой же, то есть это практически значения мощности, если переменные интерпретировать как сигналы.
Поэкспериментируем с ковариационной матрицей на более простых данных. Будем брать значение ковариации слегка зашумленных отрезков из трех точек.
Диагональный отрезок под 45°:
np.cov([1,1.9,3.1],[0.9,2.1,2.9])
array([[ 1.11, 1.04],
 [ 1.04, 1.01]])
Диагональный отрезок под -45°:
np.cov([1,1.9,3.1],[-0.9,-2.1,-2.9])
array([[ 1.11, -1.04],
 [-1.04, 1.01]])
Вертикальный отрезок:
np.cov([0,-0.1,0.1],[0.9,2.1,2.9])
array([[ 0.01, 0.04],
 [ 0.04, 1.01]])
Горизонтальный отрезок:
np.cov([0.9,2.1,2.9],[0,-0.1,0.1])
array([[ 1.01, 0.04],
 [ 0.04, 0.01]])
Как видно по результатам, ковариационная матрица чувствительна к углу поворота отрезка. Она определяет степень разброса данных и их ориентацию в пространстве. Теперь, основываясь на этой матрице, было бы хорошо найти вектор, который смотрит в сторону наибольшего разброса. Этот вектор на самом деле тот самый компонент метода PCA, который нам нужен.
Если мы еще раз нырнем в теорию, то обнаружим, что искомые векторы на самом деле являются собственными векторами ковариационной матрицы.
Итак, за работу!
# следы дедушки Ляо на двумерной плоскости - трек
track = np.array([ [2.4,0.7,2.9,2.2,3.0,2.7,1.6,1.1,1.6,0.9],
 [2.5,0.5,2.2,1.9,3.1,2.3,2,1,1.5,1.1] ])

# убираем постоянную составляющую, или среднее значение
A = track.T
M = (A-np.mean(A.T,axis=1)).T

# находим собственные числа и векторы ковариационной матрицы
[evalue,evector] = np.linalg.eig(np.cov(M))

# а это уже что-то новое
rotated_track = np.dot(evector.T,M)
Осталось запечатлеть результат работы на картинке. Красным цветом представлены собственные векторы ковариационной матрицы, которые и есть главные компоненты, или оси максимальной изменчивости данных.
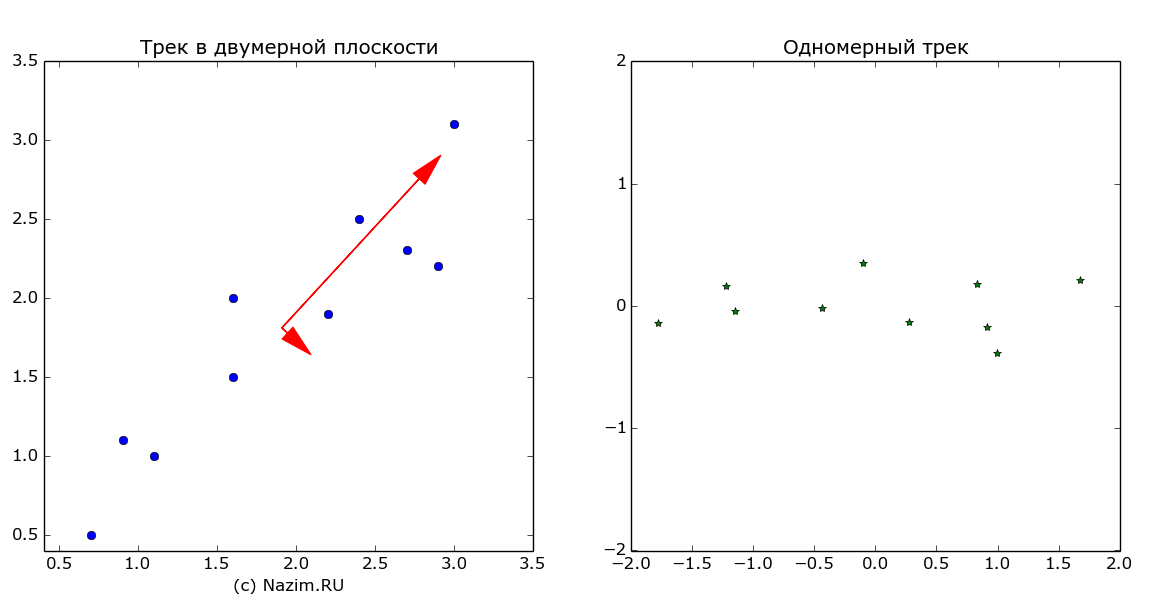
На картинке справа — тот же самый трек в новой системе координат, или проще говоря повернутый на угол одной из осей главных компонент (еще одна причина того, для чего ее нужно было искать). Такое преобразование выполняет последняя строка фрагмента программы:
rotated_track = np.dot(evector.T,M)
Кажется, подошло время к тому, чтобы сделать кое-какие выводы.
Тайное становится явным
«Человек, у которого только одни часы, точно знает который час. Обладатель двух часов ни в чем не уверен»
До сих пор все шло прекрасно. Ведь согласитесь, что мы в глубине души ожидали, что метод главных компонент подтвердит нашу не очень глубокую догадку о том, что трек дедушки Ляо проходит по оси юго-запад — северо восток. Так оно и есть. Но есть и вторая компонента, которая упрямо доказывает нам, что дедушка Ляо вполне мог двигать и по оси северо-запад — юго восток. И действительно, если ассортимент кабачка оказался забористым, герой нашего рассказа продвигался очень медленно, зато качало его из стороны в сторону будь здоров. Конечно, коротенький второй вектор говорит о том, что это направление как-бы не главное, но оно есть.
Теперь дальше. Мы действительно выделили закономерность во входном треке. Можем даже предположить, что главная компонента это и есть трек, искаженный шумом. Таким образом, мы разделили существенные и несущественные данные. И самое интересное, мы переместили трек в новую систему координат, вследствие чего он стал одномерным (говоря по научному, мы выполнили ортогонализацию). Понижение размерности входных данных — это большое достижение, например, для этого предназначены такие сложные итерационные методы, как преобразование Грама — Шмидта.
И в конце вишенка на торте. Посчитаем ковариационную матрицу повернутого трека:
np.cov(rotated_track)
[[ 1.284e+00 -4.009e-17]
[ -4.009e-17 4.908e-02]]
Если считать очень-очень маленькие числа (в степени -17) нулями, то ковариационная матрица нового трека
[[ 1.284 0]
[ 0 4.908e-02]]
стала диагональной! А это значит, что корреляция, а именно взаимозависимость между координатами x и y исчезла. Более того, малое значение корреляции для координаты y говорит о том, что мы имеем дело с шумом малой мощности. Сказанное влечет за собой важное следствие: теперь мы можем анализировать трек только по одной новой координате x, не обращая внимания на другую: она в силу ортогональности системы не оказывает никакого влияния.
Вернемся еще раз к собственным векторам. При программировании метода главных компонент, вычислительная сложность падает именно на алгоритм нахождения этих векторов. Это нужно учитывать при реализации, чтобы не получить проблемы с быстродействием системы.
Всем большой привет от дедушки Ляо!
Updated, или как все это было посчитано
Из комментариев стало ясно, что нужно заполнить пробелы этой статьи — более подробно рассказать, как были получены данные. Поэтому даю фрагмент псевдокода Python, из которого все должно быть ясно:
# исходный трек
track = np.array([ [2.4,0.7,2.9,2.2,3.0,2.7,1.6,1.1,1.6,0.9],
[2.5,0.5,2.2,1.9,3.1,2.3,2,1,1.5,1.1] ]
# убираем смещение из трека
A = track.T
M = (A-np.mean(A.T,axis=1)).T

# находим собственные числа и векторы
[evalue,evector] = np.linalg.eig(np.cov(M))
# готовим собственные векторы для отрисовки
m = np.mean(track,axis=1)
r0 = evector.T*evalue
r = r0.T

# в левом окне:
# рисуем собственные векторы с учетом смещения
ax.arrow(m[0], m[1], -r[0,1], r[0,0])
ax.arrow(m[0], m[1], r[1,1], -r[1,0])
# также рисуем наш трек
ax.plot(track[0,:],track[1,:])

# в правом окне:
# рисуем трек в новом базисе
score = np.dot(evector.T,M)
plt.plot(score[0,:],score[1,:])
Картинку тоже подредактировал, теперь она в правильном масштабе


Добавить комментарий